Crawling, indeksering & bot-styring
Sådan finder og indekserer Google jeres sider, og sådan styrer I robots.txt, sitemaps og AI-crawlere som GPTBot, OAI-SearchBot og ClaudeBot.
Mange marketing- og især SEO-folk taler om indeksering, men ordet dækker over en kæde af processer, der hver især kan gå galt. Denne guide følger kæden fra det øjeblik, crawleren finder en URL, til siden står i indekset. Den viser, hvordan I styrer adgangen med robots.txt og sitemaps, hvordan I forholder jer til de mange AI-crawlere, og hvordan I tjekker, at det hele virker.
Fra crawl til indeks: tre led
Crawling er det første led. Googles crawler, Googlebot, henter sider, den allerede kender, og opdager nye ved at følge links fra kendte sider eller ved at læse jeres sitemap. Under crawlet renderer Google siden med en nyere version af Chrome, så indhold, der først opstår via JavaScript, også kan blive læst. Rendering koster dog ekstra ressourcer, og derfor har vi en særskilt guide til JavaScript og rendering.
Indeksering er andet led. Google analyserer indholdet, grupperer sider med det samme eller næsten samme indhold og vælger den mest repræsentative som kanonisk version. Først derefter kan siden komme i indekset. Google skriver selv, at hverken crawling eller indeksering er garanteret, heller ikke for sider, der følger retningslinjerne (How Search works).
Visning er sidste led. Når nogen søger, finder Google de sider i indekset, der bedst matcher søgningen, og rangerer dem på resultatsiden, den såkaldte SERP. Indeksering og rankings bliver ofte blandet sammen, men en side kan sagtens være indekseret og alligevel ligge på side ni.
Kæden gælder også for Googles AI-flader. For at blive vist som kilde i AI Overviews eller AI Mode skal en side være indekseret og kunne vises med et uddrag i Google Search. Der findes ingen ekstra krav eller særlig optimering (Google: AI features and your website). ChatGPT, Claude og Perplexity bygger derimod på egne crawlere, som I styrer hver for sig. Det kommer vi til længere nede.
Sådan hjælper I crawlere og indeksering
Interne links og arkitektur
Crawlere finder jeres sider ved at følge links. En side, der kun kan nås via sitets søgefunktion eller tre klik nede i et filter, bliver sjældnere besøgt end en side, der linkes til fra menuen og fra relevante artikler. Interne links og en klar taksonomi er derfor den mest direkte måde at fortælle Google, hvilke sider der betyder noget. Sitemappet supplerer linkstrukturen, men erstatter den ikke.
Indhold, der fortjener en plads i indekset
Google indekserer ikke alt, den crawler. Tynde sider, næsten ens varianter og sider uden selvstændig værdi ender ofte i Search Consoles kategori "Crawlet – ikke indekseret i øjeblikket". Indeksering er derfor ikke kun et teknisk spørgsmål. Sider, der er bygget op omkring et konkret behov og de keywords, målgruppen bruger, har bedre chancer for at blive optaget og blive der. Arbejdet starter typisk med en søgeordsanalyse, og vi har lavet en skabelon, I er velkomne til at bruge:
→ Download gratis søgeordsanalyse template
Teknisk sundhed
Mange 404-sider, redirect-kæder, sider uden metatags og orphan sider (sider uden interne links) gør det sværere for crawleren at bruge tiden fornuftigt. Det rammer især store sites, hvor Google skal prioritere, hvad den når at hente. Oprydningen gennemgår vi i guiden om site health, redirects og canonicals.
Links fra andre sites
Links fra relevante eksterne sider hjælper på to måder. De er en vej, hvorpå crawlere opdager jeres sider, og de øger Googles interesse for at crawle dem igen. Samtidig er de et signal om troværdighed, som har betydning for, hvordan siderne klarer sig, når de først er i indekset. Mere om det i guiden til linkbuilding.
Tjek om jeres sider er indekseret
Helt nye sider og sider med få links er typisk dem, der mangler i indekset. Der er to hurtige måder at tjekke status på.
Search Console: URL-inspektion og sideindeksering
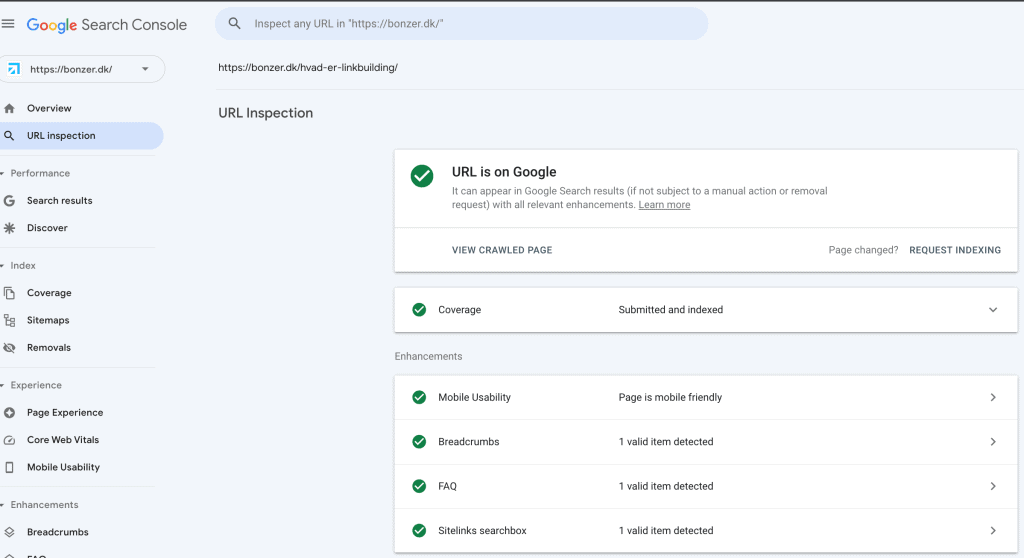
I Google Search Console indsætter I en URL i søgefeltet øverst. URL-inspektionen viser, om siden er i indekset, hvornår den sidst blev crawlet, og hvilken URL Google har valgt som kanonisk. Er siden ikke indekseret, kan I anmode om indeksering samme sted. Rapporten "Sider" under Indeksering giver det samlede billede: hvor mange URL'er der er indekseret, og hvorfor resten ikke er det, fx "Udelukket af noindex-tag", "Blokeret af robots.txt" eller "Dublet uden brugervalgt kanonisk side".
site:-kommandoen
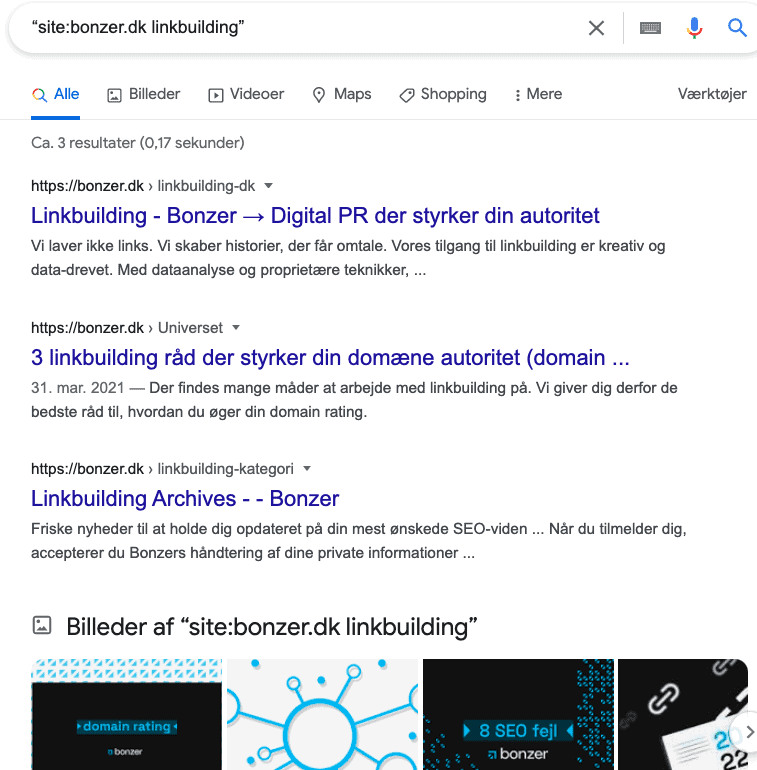
Skriv site:domæne.dk søgeord i Google eller Bing, så ser I de sider fra jeres domæne, søgemaskinen har indekseret og forbinder med søgeordet. Kommandoen er god til et hurtigt stikprøvetjek, men antallet af resultater er et groft skøn og ikke en komplet liste over indekset. Præcise svar får I i Search Console.
Robots.txt i dybden
Robots.txt er en tekstfil i roden af domænet, fx https://www.example.dk/robots.txt, som fortæller crawlere, hvilke URL'er de må hente. Ifølge Google bruges filen primært til at undgå, at sitet bliver overbelastet af forespørgsler, og den er ikke en metode til at holde en side ude af Google (Google: Introduction to robots.txt).
Syntaksen
Filen består af grupper. Hver gruppe starter med en eller flere User-agent-linjer efterfulgt af regler:
# Regler for alle crawlere uden egen gruppe
User-agent: *
Disallow: /kurv/
Disallow: /*?sort=
Allow: /

# OpenAIs træningscrawler må ikke hente noget
User-agent: GPTBot
Disallow: /

Sitemap: https://www.example.dk/sitemap.xml
Google fortolker filen efter nogle få regler, I bør kende, før I ændrer i den (Google: How Google interprets the robots.txt specification):
- Én gruppe pr. crawler. En crawler følger kun den gruppe, der matcher dens navn mest specifikt. Har GPTBot sin egen gruppe, ignorerer den alt under
User-agent: *. Giver I en bot sin egen gruppe for at tillade den noget, skal I altså gentage de generelle forbud i den gruppe. - Den længste regel vinder. Matcher både
AllowogDisallowen URL, gælder reglen med den længste sti. Er de lige lange, vælger Google den mindst restriktive. - Wildcards.
*matcher en vilkårlig tekststreng, og$markerer slutningen af URL'en.Disallow: /*.pdf$blokerer altså alle PDF'er. - Stier skelner mellem store og små bogstaver.
Disallow: /Kampagne/blokerer ikke/kampagne/. - Filen gælder én vært.
www.example.dk,shop.example.dkoghttp://-udgaven har hver deres robots.txt. - Statuskoden tæller. Returnerer robots.txt en 4xx-fejl, opfatter Google det, som om der ingen begrænsninger er. Ved 5xx-fejl stopper Google crawlingen midlertidigt. Google cacher normalt filen i op til 24 timer og læser kun de første 500 KiB.
Typiske fejl
Disallow: /følger med fra testmiljøet. Den klassiske fejl efter en lancering. Hele sitet bliver lukket for crawling, og det opdages ofte først, når trafikken falder.- Blokeret CSS og JavaScript. Kan Google ikke hente de filer, siden skal bruge, renderer den en ufuldstændig version.
- Robots.txt bruges til at fjerne sider fra Google. En blokeret URL kan stadig blive indekseret, hvis andre linker til den. Den vises så uden beskrivelse i resultaterne.
- En side er både blokeret og sat til noindex. Google kan ikke læse et noindex-tag på en side, den ikke må crawle, og så virker tagget ikke.
- Direktiver, Google ikke understøtter.
Crawl-delayignoreres af Google, ognoindexi robots.txt har ikke virket siden 2019. Nogle andre crawlere respekterer dogCrawl-delay, fx Anthropics bots.
Robots.txt eller noindex?
De to værktøjer løser forskellige opgaver, og de virker ikke sammen på samme URL.
Robots.txt (Disallow) | Noindex (meta-tag eller X-Robots-Tag) | |
|---|---|---|
| Styrer | Om en crawler må hente URL'en | Om en hentet side må stå i indekset |
| Kan siden blive indekseret? | Ja, hvis andre linker til den, men uden indhold og beskrivelse | Nej, når Google har crawlet siden og set tagget |
| Sparer crawl-ressourcer? | Ja | Nej, siden skal crawles, for at tagget bliver læst |
| Brug den til | Filtre, parametre, interne søgesider og andet, der ikke skal crawles | Sider, der skal kunne besøges, men ikke vises i søgeresultaterne |
Skal en side ud af indekset, sætter I <meta name="robots" content="noindex"> i sidens <head> eller sender en X-Robots-Tag: noindex-header, og lader siden være åben for crawling, indtil den er væk (Google: Block search indexing with noindex). Afhængigt af sidens betydning kan der gå måneder, før Google kommer forbi igen, så til hastesager bruger I fjernelsesværktøjet i Search Console. Hvad der sker, når en side ryger ud af indekset, har vi beskrevet under de-indeksering.
AI-crawlere: træning, søgning og brugerhentning
Robots.txt var i mange år et spørgsmål om Googlebot og Bingbot. I dag kommer der trafik fra en lang række AI-tjenester, og de fleste store udbydere har delt deres bots op efter formål. Det giver jer mulighed for at sige nej til træning uden at sige nej til synlighed, men det kræver, at I kender forskel på tre typer bots:
- Træningsbots henter indhold, der kan indgå i træningen af fremtidige modeller. En blokering påvirker ikke, om I bliver vist i dag.
- Søgebots bygger det indeks, som AI-tjenestens søgefunktion henter kilder fra. En blokering kan betyde, at I ikke bliver vist eller citeret.
- Brugerhentere besøger en side, fordi en bruger har bedt om det i en samtale. Flere af dem følger ikke robots.txt, fordi forespørgslen er brugerinitieret.
Botterne hos de store udbydere
Oversigten bygger på udbydernes egen dokumentation pr. oktober 2026. Botnavne og regler ændrer sig, så tjek kilderne, før I ændrer i jeres egen fil.
| Udbyder | Bot | Bruges til | Hvis I blokerer den |
|---|---|---|---|
| OpenAI | GPTBot | Indhold, der kan bruges til at træne OpenAIs modeller | Signalerer, at indholdet ikke skal bruges til træning. Påvirker ikke ChatGPT's søgesvar |
| OpenAI | OAI-SearchBot | Kilder til søgefunktionen i ChatGPT | Siderne bliver ikke vist i ChatGPT's søgesvar. Ændringen slår igennem efter ca. 24 timer |
| OpenAI | ChatGPT-User | Besøg, når en bruger beder ChatGPT hente en side | Robots.txt gælder ikke nødvendigvis, da handlingen er brugerinitieret |
| Anthropic | ClaudeBot | Indhold, der kan bruges til at træne Anthropics modeller | Fremtidigt indhold udelades af træningsdata |
| Anthropic | Claude-SearchBot | Indeksering, der forbedrer Claudes søgesvar | Kan reducere jeres synlighed i Claudes søgeresultater |
| Anthropic | Claude-User | Besøg, når en bruger stiller Claude et spørgsmål | Claude kan ikke hente jeres sider til brugerens svar |
| Perplexity | PerplexityBot | Indeks til Perplexitys søgeresultater. Bruges ikke til træning af foundation-modeller | Siderne bliver ikke fundet og linket i Perplexity |
| Perplexity | Perplexity-User | Besøg, når en bruger stiller et spørgsmål | Følger generelt ikke robots.txt |
| Googlebot | Google Search, herunder AI Overviews og AI Mode | Siderne forsvinder fra både de blå links og AI-svarene | |
| Google-Extended | Ingen egen crawler, kun et token i robots.txt. Styrer træning af Gemini-modeller og grounding i Gemini-apps og Vertex AI | Ingen effekt på Google Search eller rankings | |
| Apple | Applebot | Søgning i Spotlight, Siri og Safari. Data kan også bruges til træning | Siderne forsvinder fra Apples søgefunktioner |
| Apple | Applebot-Extended | Ingen egen crawler. Styrer, om indhold må bruges til træning af Apples modeller | Siderne kan stadig vises i Apples søgefunktioner |
Kilder: OpenAI, Anthropic, Perplexity, Google og Apple. OpenAI skriver eksplicit, at indstillingerne er uafhængige af hinanden, så I kan tillade OAI-SearchBot og blokere GPTBot.
To nuancer bliver ofte misforstået. Google-Extended styrer ikke AI Overviews. AI Overviews og AI Mode er en del af Google Search og bygger på Googlebots indeks. Vil I begrænse, hvad Google viser fra jeres sider dér, er værktøjerne nosnippet, data-nosnippet, max-snippet og noindex, og de påvirker også jeres almindelige søgeresultater. Microsoft har ingen separat træningsbot. Bingbot henter indhold til både Bing og Copilot, og brugen i AI-svar og træning styres i stedet med meta-taggene noarchive og nocache (Bing Webmaster Blog).
Hvad skal I vælge?
Vil I være synlige, når kunderne bruger ChatGPT, Claude, Perplexity og Googles AI-svar, skal søgebots og brugerhentere kunne komme ind. Træningsbots er en forretningsbeslutning. Et medie, der lever af sit indhold, kan have gode grunde til at sige nej, mens en B2B-virksomhed ofte har en interesse i, at modellerne kender dens produkter og fagområde. Der er ikke ét rigtigt svar, men beslutningen bør være truffet bevidst og ikke være en tilfældig standardindstilling.
Hvordan de enkelte AI-tjenester finder og bruger kilder, gennemgår vi i guiderne til ChatGPT, Claude, Perplexity og Google AI Overviews.
Skjulte blokeringer i CDN og firewall
En korrekt robots.txt hjælper ikke, hvis forespørgslen bliver afvist, før den når frem til sitet. CDN'er og web application firewalls har i dag færdige regler mod AI-crawlere og "mistænkelige" bots, og de kan være slået til, uden at marketingafdelingen ved det. Robots.txt siger ja, men firewallen svarer med 403 eller en udfordringsside.
Cloudflare er det mest udbredte eksempel. Den gamle "Block AI bots"-knap er udfaset pr. 15. september 2026 og erstattet af indstillinger for tre kategorier: Search, Agent og Training. Nye domæner får fra samme dato en standard, hvor Training- og Agent-bots blokeres på sider med annoncer, mens Search er tilladt (Cloudflare changelog). Vær særligt opmærksomme på crawlere, der bruges til både søgning og træning, fx Googlebot, Bingbot og Applebot. Cloudflare skriver selv, at en fuld blokering af træning stopper dem helt, også til søgning, mens indstillingen "Disallow AI Training" lader dem fortsætte til søgning (Cloudflare blog).
Når en AI-tjeneste eller søgemaskine ikke ser ud til at kende jeres sider, skal I derfor tjekke robots.txt, bot- og firewallindstillingerne i jeres CDN og serverlogs for 403- og 429-svar til de relevante user agents.
Crawl budget: hvornår det betyder noget
Crawl budget er den mængde URL'er, Google kan og vil crawle på jeres site. Det består af to dele: den kapacitet, jeres server kan holde til, og den efterspørgsel, Google har efter jeres sider. Google skriver selv, at emnet primært er relevant for sites med over en million unikke sider, der ændrer sig ugentligt, sites med over 10.000 sider, der ændrer sig dagligt, og sites med mange URL'er i kategorien "Fundet – ikke indekseret i øjeblikket" (Google: Crawl budget management).
For et site med nogle hundrede sider er crawl budget sjældent problemet. På store webshops og mediesites er det ofte her, nye sider bliver liggende. Typiske årsager er:
- Facetteret navigation og parametre, der skaber tusindvis af næsten ens URL'er. Luk de varianter, der ikke skal crawles, i robots.txt. Noindex sparer ikke crawl budget, fordi siden stadig skal hentes.
- Soft 404'er, altså tomme sider eller fejlsider, der returnerer statuskode 200. Returnér 404 eller 410 for sider, der er væk.
- Redirect-kæder, hvor hvert hop koster en ekstra forespørgsel.
- Langsomme serversvar. Svarer serveren langsomt, sænker Google tempoet for ikke at overbelaste den.
Et opdateret sitemap med korrekt <lastmod> og understøttelse af statuskoden 304 (Not Modified) hjælper Google med at bruge tiden på de sider, der er ændret.
Sådan verificerer I crawlingen
Crawlstatistik i Search Console
Rapporten over crawlstatistik ligger under Indstillinger i Search Console. Den viser antallet af forespørgsler over tid, den gennemsnitlige svartid og en opdeling efter statuskode, filtype, formål (opdagelse eller opdatering) og Googlebot-type. Under "Værtsstatus" kan I se, om Google har haft problemer med at hente robots.txt, slå DNS op eller forbinde til serveren. Google skriver, at sites med under tusind sider normalt ikke behøver rapporten (Search Console Help: Crawl Stats report). For større sites er et pludseligt fald i forespørgsler eller en stigning i 5xx-svar ofte det første tegn på et problem.
Under Indstillinger finder I også robots.txt-rapporten, der viser, hvilken version af filen Google senest har hentet, og om den indeholder fejl.
Serverlogs
Serverlogs er det eneste sted, hvor I ser alle crawlere, også AI-tjenesternes. Her kan I se, hvilke URL'er hver bot henter, hvor ofte, og hvilke statuskoder den får, og om GPTBot, OAI-SearchBot, ClaudeBot eller PerplexityBot overhovedet kommer forbi. Gode spørgsmål at stille til loggene:
- Bruger Googlebot tiden på de sider, der skal rangere, eller på parametre og filtre?
- Får bestemte bots 403, 429 eller 5xx, mens almindelige besøgende får 200?
- Hvor længe går der, fra en ny side bliver publiceret, til den bliver crawlet?
User agents kan forfalskes, så verificér trafikken, før I konkluderer noget. Google beskriver, hvordan I bekræfter Googlebot med reverse og forward DNS-opslag eller med de offentliggjorte IP-intervaller (Google: Verifying Googlebot), og OpenAI offentliggør IP-intervaller for sine bots i den dokumentation, vi linker til ovenfor. Vil I følge, hvordan AI-trafikken udvikler sig over tid, har vi skrevet om det i guiden til LLM-overvågning.
Sitemap: Googles turistkort over jeres hjemmeside
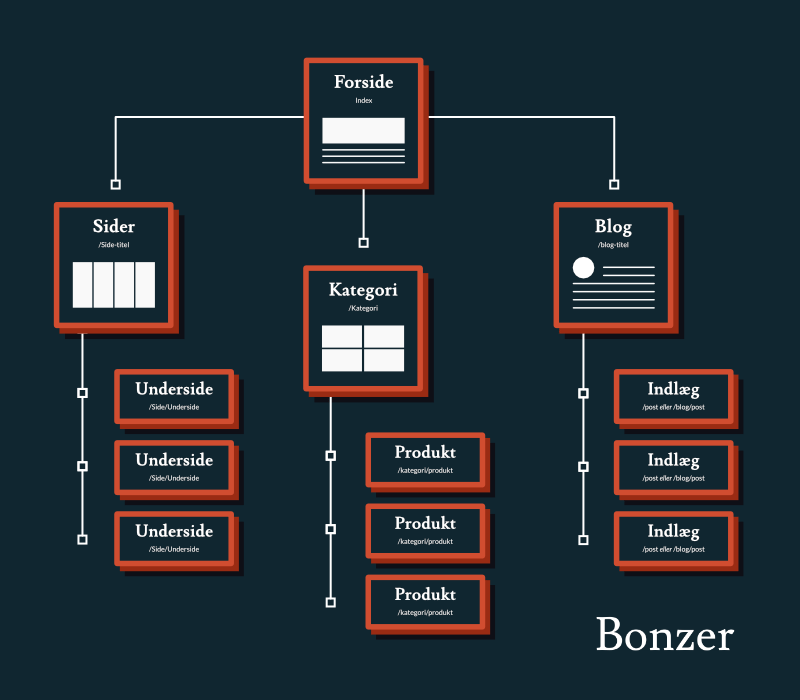
Et sitemap er en liste over de sider, billeder og videoer, der er på jeres domæne, og det kan samtidig fortælle, hvornår hver URL sidst blev ændret. Et sitemap kan laves til mennesker eller til maskiner. Her handler det om dem til maskinerne.
Fem typer sitemaps
XML-sitemap er en fil til søgemaskinerne med jeres URL'er og eventuelle ekstra oplysninger, fx hvornår siden sidst blev ændret. Den indsendes via Search Console og er ikke beregnet til brugerne.
HTML-sitemap er en almindelig side, der linker til sitets vigtigste sider. Den hjælper både brugere og crawlere med at finde rundt.
Video- og billedsitemaps giver Google ekstra oplysninger om visuelt indhold, så det lettere kan blive fundet i video- og billedsøgninger.
Nyhedssitemap hjælper Google med at finde nyt indhold til Google News. Der er ikke længere en ansøgningsproces. Udgivere bliver automatisk vurderet til Top stories og fanen Nyheder, hvis indholdet lever op til Google News' politikker (Google Publisher Center Help).
Et sitemap garanterer hverken crawling, indeksering eller bedre rankings. Det hjælper søgemaskinerne med at finde sider, de ellers ville have svært ved at opdage, især nye sider og sider med få interne og eksterne links.
Det skal et sitemap indeholde
Google stiller nogle få krav (Google: Build and submit a sitemap):
- Kun kanoniske URL'er, der returnerer 200 og må indekseres. Sider med noindex, redirects og dubletter hører ikke hjemme i sitemappet, fordi de sender modstridende signaler.
- Absolutte URL'er med protokol og domæne, fx
https://www.example.dk/side/. - Højst 50.000 URL'er og 50 MB ukomprimeret pr. fil. Større sites deler sitemappet op og samler filerne i et sitemap-indeks.
- Et korrekt
<lastmod>. Google bruger datoen, når den konsekvent passer.<priority>og<changefreq>ignorerer Google. - UTF-8-kodning.
Statisk eller dynamisk?
Et statisk sitemap laver I selv og har fuld kontrol over, men det skal opdateres manuelt, hver gang I opretter eller sletter en side. De fleste vælger et dynamisk sitemap, som CMS'et eller et plugin vedligeholder automatisk. WordPress (fra version 5.5), Shopify og mange andre systemer laver det selv. Ulempen er, at det kan være sværere at styre, hvilke sider der kommer med.
XML, RSS eller tekst?
Google understøtter tre formater. XML er det mest udbredte, fordi det let kan genereres automatisk og kan udvides med billeder, video, nyheder og sprogversioner. RSS, mRSS og Atom bliver ofte lavet automatisk af CMS'er til blogs. Tekst er en almindelig UTF-8-fil med én fuld URL pr. linje. Det er den enkleste form, men den kan ikke indeholde ekstra oplysninger.
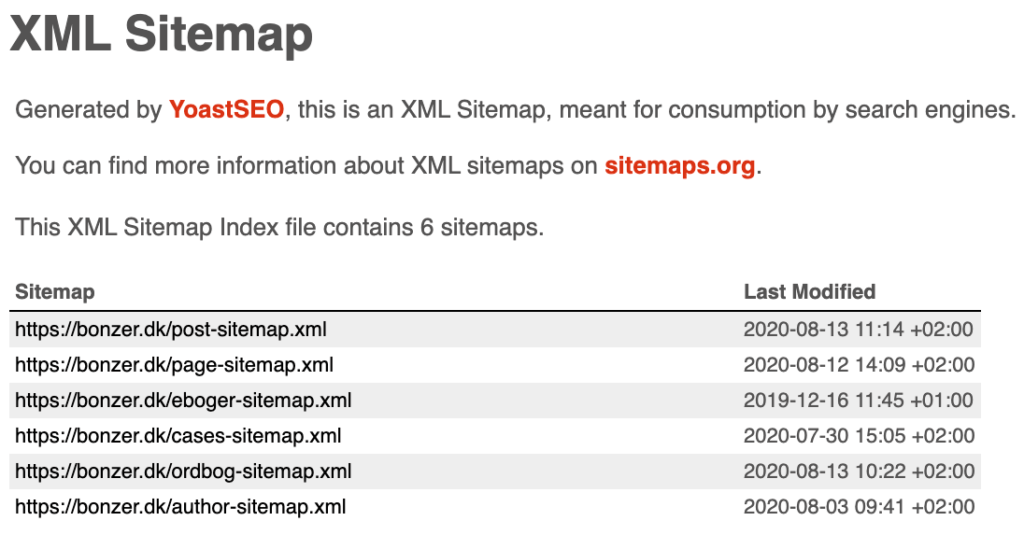
Eksempel på et XML-sitemap
Et simpelt XML-sitemap med en almindelig URL og en URL med et billede ser sådan ud:
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9" xmlns:image="http://www.google.com/schemas/sitemap-image/1.1">
	<url>
		<loc>https://www.example.dk/</loc>
		<lastmod>2026-09-28T09:13:28+00:00</lastmod>
	</url>
	<url>
		<loc>https://www.example.dk/guides/crm-system/</loc>
		<lastmod>2026-08-14T14:10:51+00:00</lastmod>
		<image:image>
			<image:loc>https://www.example.dk/billeder/crm-system.jpg</image:loc>
		</image:image>
	</url>
</urlset>
Placering og indsendelse
Sitemappet ligger typisk i roden af domænet, fx https://www.example.dk/sitemap.xml. Har sitet flere subdomæner, skal hvert subdomæne have sit eget. Henvis til sitemappet i robots.txt med en Sitemap:-linje, så alle crawlere kan finde det, også AI-tjenesternes.
Indsend det derefter i rapporten Sitemaps i Google Search Console. Her kan I se, hvornår Google sidst læste filen, og om den indeholder fejl. Det er især nyttigt på et helt nyt site, hvor der endnu ikke er mange links, crawleren kan følge.
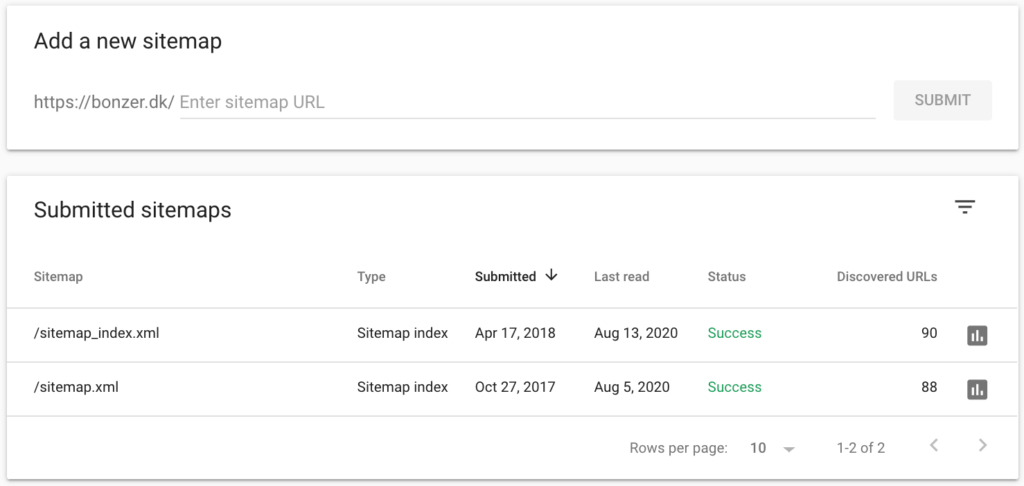
Sitemap-generatorer og plugins
En ekstern sitemap-generator giver et statisk øjebliksbillede af sitet på det tidspunkt, I kørte den. Tilføjer I jævnligt nyt indhold, er et dynamisk sitemap fra CMS'et et bedre valg.
På WordPress har vi god erfaring med Yoast, der genererer et XML-sitemap automatisk og gør det muligt at udelukke sider, sætte dem til noindex og angive canonical. Siden version 5.5 (august 2020) laver WordPress også selv et sitemap. Bruger I et plugin eller et hjemmelavet sitemap, så tjek, om I bør:
- Gøre ingenting, fordi pluginet allerede har slået WordPress' sitemap fra
- Deaktivere WordPress' sitemap
- Fjerne jeres gamle sitemap
To sitemaps med forskelligt indhold sender modstridende signaler om, hvilke sider der skal indekseres.
Få et overblik over jeres tekniske fundament
Er I i tvivl om, hvorvidt jeres robots.txt, sitemap eller CDN-indstillinger står i vejen for søgemaskiner og AI-tjenester, kan I bestille en gratis SEO-analyse. Den er udarbejdet manuelt og giver et overblik over sitets tekniske sundhed og potentiale i både klassisk search og AI-search. Til en fuld gennemgang af crawling, indeksering og logfiler har vi en teknisk SEO-audit.
Ofte stillede spørgsmål om crawling og indeksering
Crawling er, når en søgemaskines crawler henter en side. Indeksering er, når søgemaskinen har analyseret siden og optaget den i sit indeks. En side kan blive crawlet uden at blive indekseret, fx hvis den er en dublet eller har for lidt selvstændigt indhold.
Nej. Robots.txt forhindrer crawling, ikke indeksering. En blokeret URL kan stadig blive vist, hvis andre linker til den. Skal en side ud af indekset, bruger I noindex og lader siden være åben for crawling, så Google kan læse tagget.
Ikke fra ChatGPT's søgesvar. GPTBot indsamler træningsdata, mens OAI-SearchBot henter de kilder, ChatGPT viser i søgesvar. OpenAI skriver, at de to indstillinger er uafhængige, så I kan blokere GPTBot og tillade OAI-SearchBot.
Nej. Google-Extended styrer brugen af indhold til træning og grounding i Gemini-apps og Vertex AI. AI Overviews og AI Mode er en del af Google Search og styres med de almindelige søgekontroller som noindex og nosnippet.
Ofte fordi et CDN eller en firewall blokerer dem, før robots.txt overhovedet bliver læst. Tjek bot-indstillingerne hos jeres CDN, fx Cloudflare, og kig i serverlogs efter 403- og 429-svar til de relevante user agents.
De mest brugte er XML- og HTML-sitemaps. Hertil kommer video-, billed- og nyhedssitemaps. XML-sitemappet er til søgemaskinerne, mens et HTML-sitemap er en almindelig side, som også brugerne kan se.
Typisk /sitemap.xml i roden af domænet, fx example.dk/sitemap.xml. Mange CMS'er bruger et sitemap-indeks med en anden adresse. Kan I ikke finde det, så kig efter en Sitemap-linje i robots.txt eller i CMS'ets dokumentation.
Ja, fra og med WordPress 5.5. Bruger I et SEO-plugin som Yoast, slår det typisk WordPress' eget sitemap fra og laver sit eget.
XML, kodet i UTF-8. Det understøttes af alle de store søgemaskiner og kan udvides med billeder, video og sprogversioner.